AI-炼丹01
AI画图-StableDiffusion
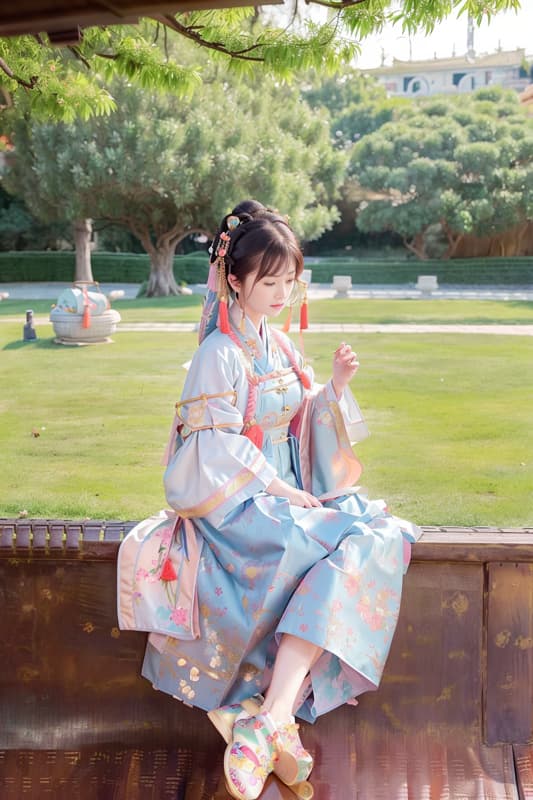
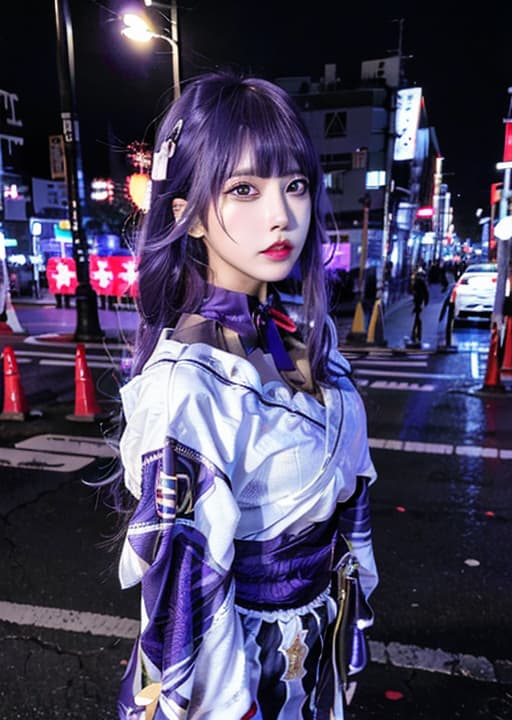
前言 最近AI很火🔥,先是AI画图,然后就ChatGPT,后者我已经用了一段时间了,用来写作文挺不错的,但OpenAI屏蔽了中国IP,加上用户太多啥的,用起来没那么爽,但没办法全球只此一家,只能捏着鼻子用。而AI画图就不一样了,全是开源的,自己部署一下可以玩个爽~ 正好我们这有台2080Ti的工作站,之前用来训练模型的,现在部署个画图应该轻轻松松,于是就开始了折腾之路~ 效果 先看看我生成出来的
阅读全文
前言 最近AI很火🔥,先是AI画图,然后就ChatGPT,后者我已经用了一段时间了,用来写作文挺不错的,但OpenAI屏蔽了中国IP,加上用户太多啥的,用起来没那么爽,但没办法全球只此一家,只能捏着鼻子用。而AI画图就不一样了,全是开源的,自己部署一下可以玩个爽~ 正好我们这有台2080Ti的工作站,之前用来训练模型的,现在部署个画图应该轻轻松松,于是就开始了折腾之路~ 效果 先看看我生成出来的
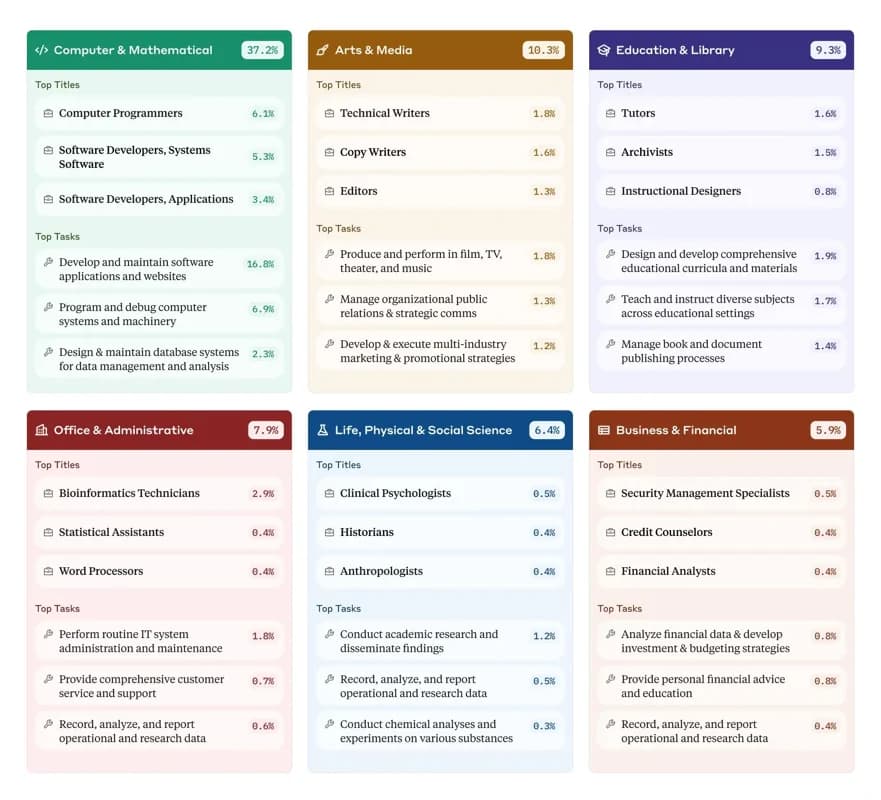
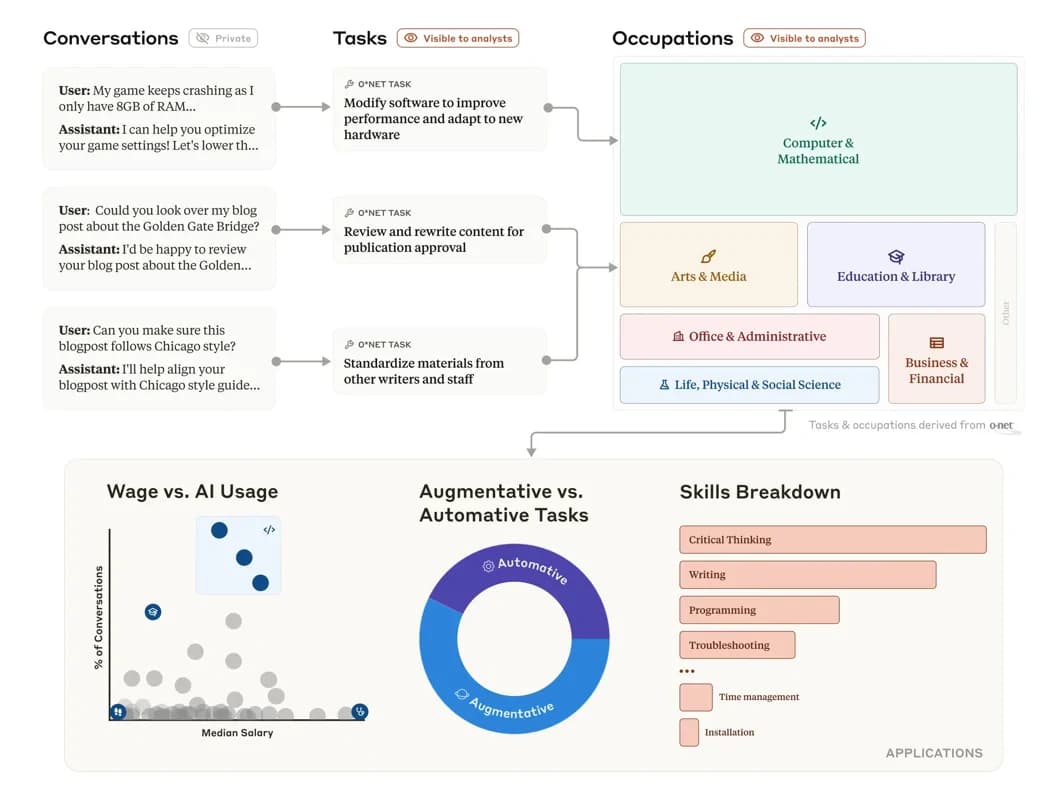
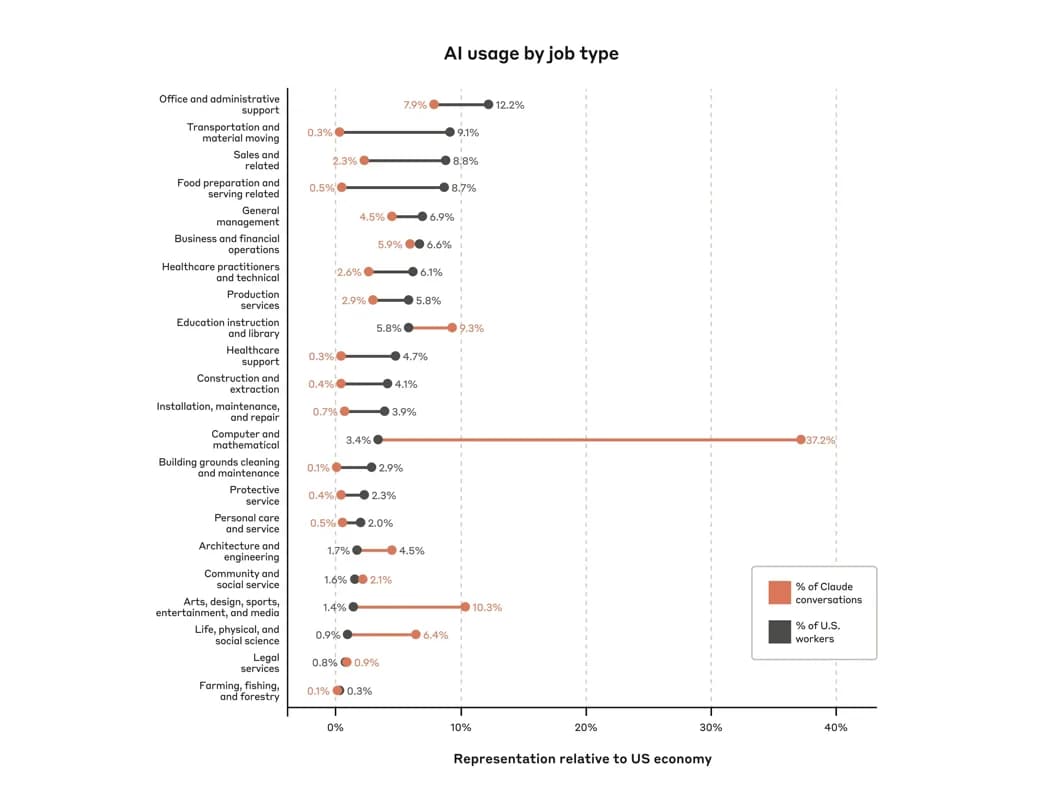
Anthropic 的报告揭示,AI 主要用于编程和写作,36% 职业至少 25% 任务涉及 AI,增强占 57% 而非自动化。中高薪职业更常见,低薪和超高薪反而少用,真讽刺?数据开源,但分不清工作用途,局限性明显。
自编译折腾半天,加速不到2倍?小模型+Windows+gfx1032非官方支持,能有这个速度算给面子了。别指望生产环境,当实验玩具玩吧。
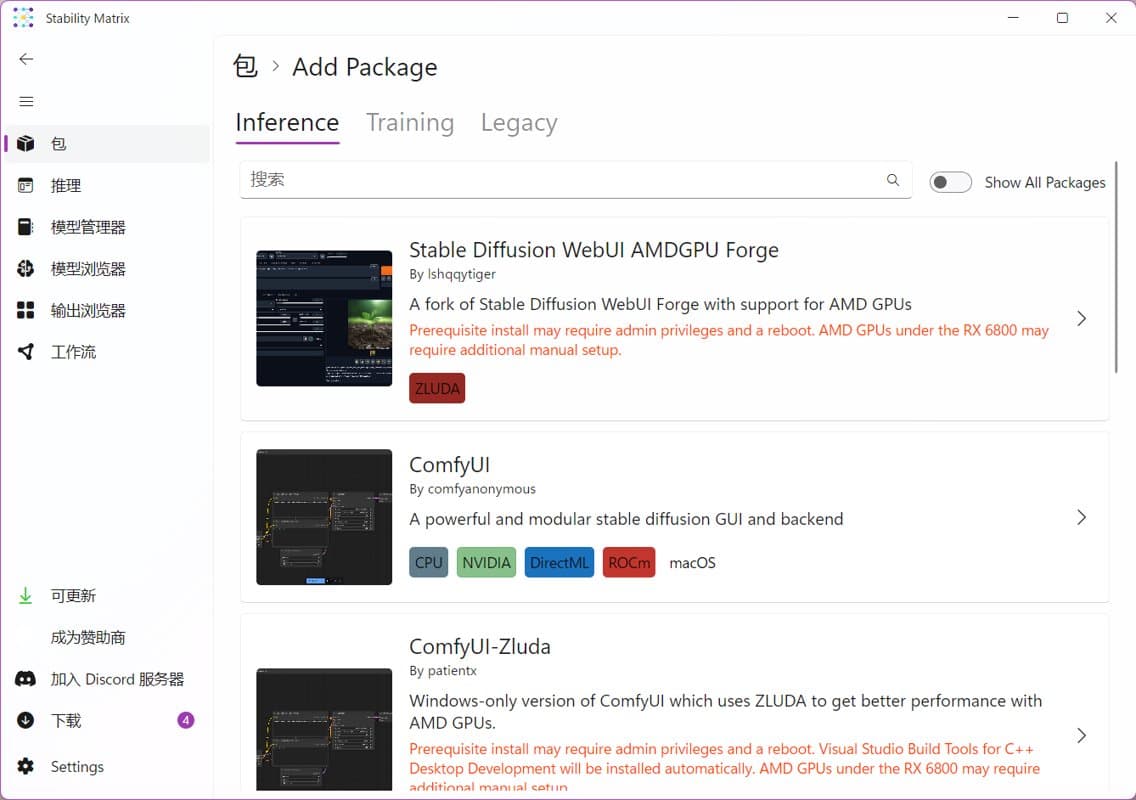
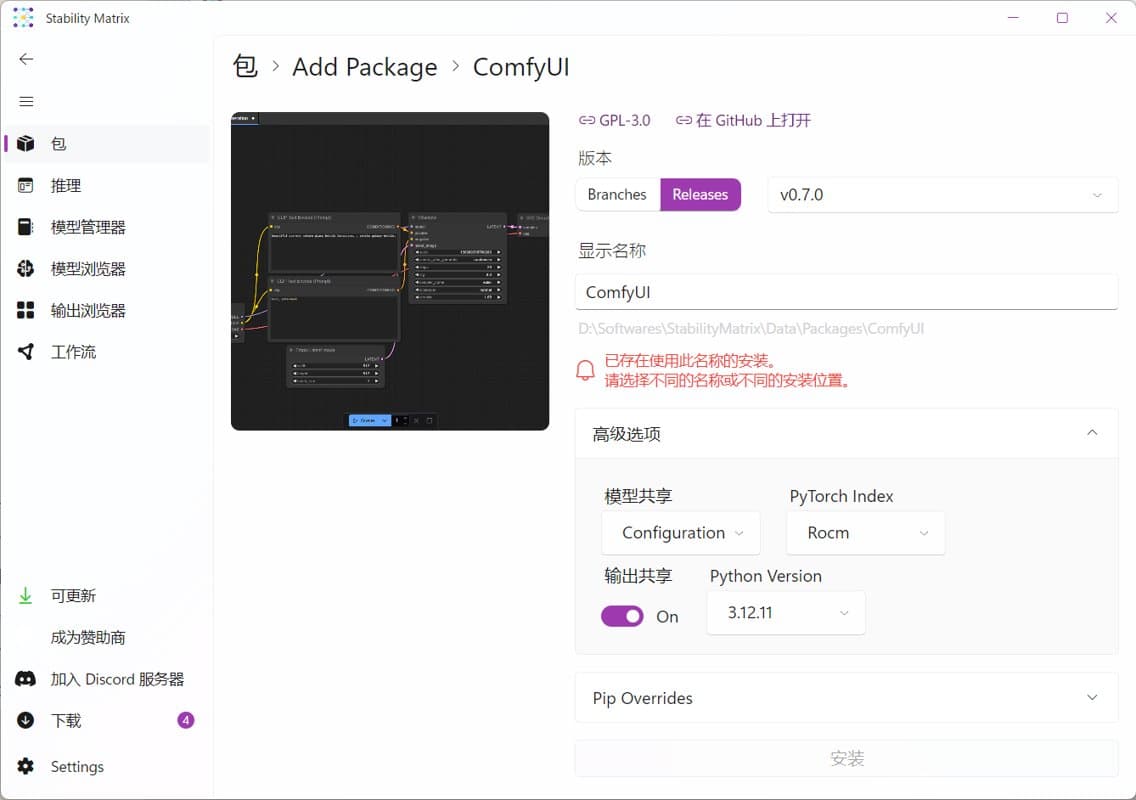
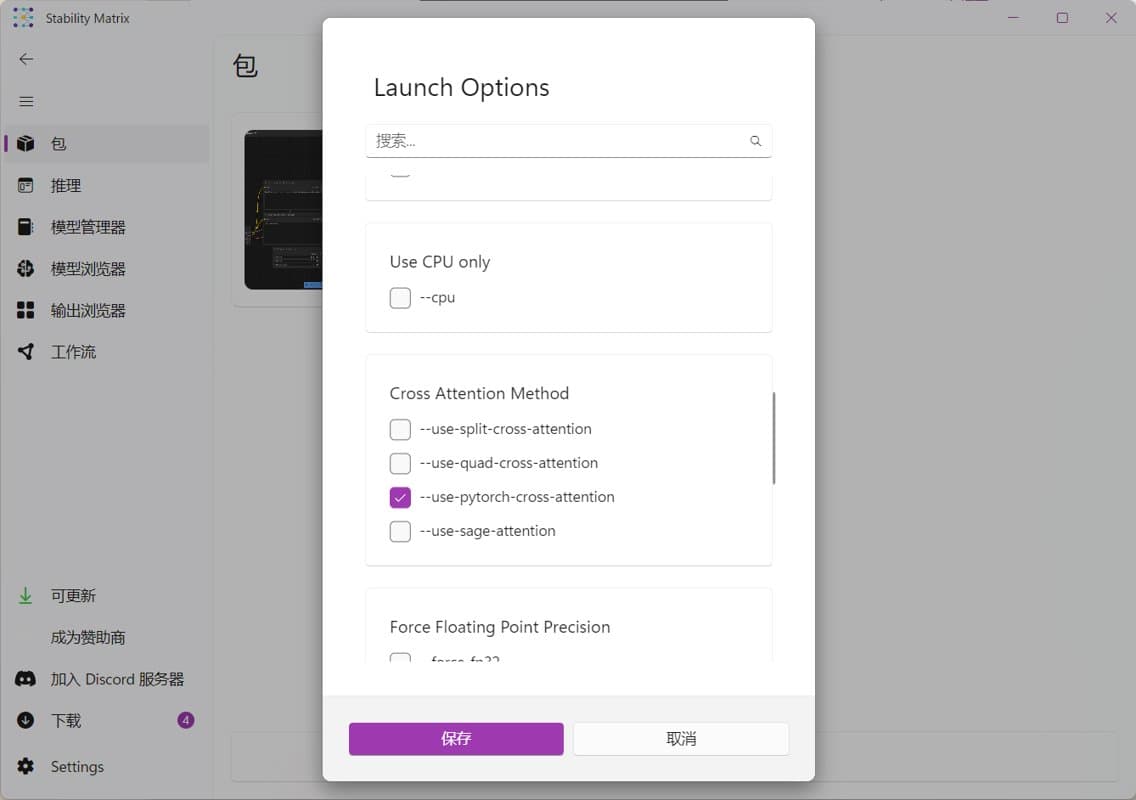
用StabilityMatrix在AMD显卡上部署ComfyUI,总算让ROCm派上点正经用场。可视化工作流比早期那堆破烂配置界面强多了,虽然启动时还得手动补依赖。看着GPU利用率拉满生成图像,这才算没白折腾。
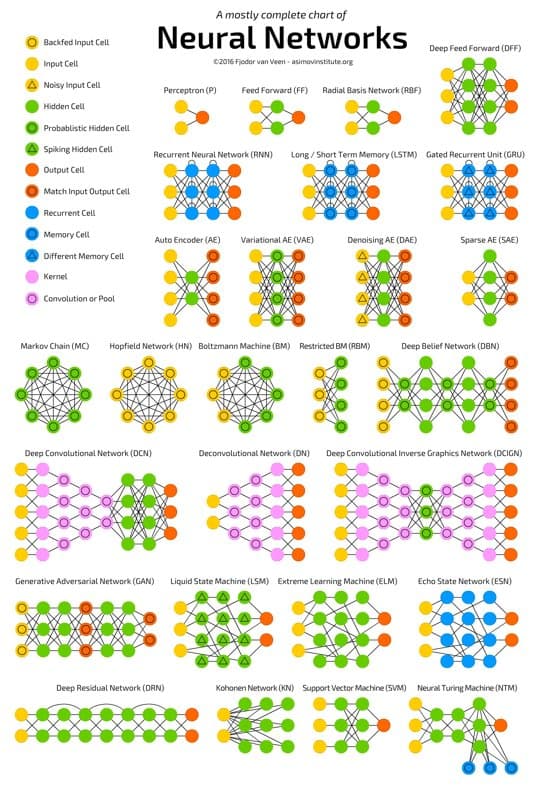
在Windows+AMD的debuff下硬是编译了ROCm版PyTorch,拿MNIST这种“Hello World”来验货。用CNN而不是老掉牙的全连接网络,总算对得起显卡算力。跑完500个batch损失降到0.03,这种基础任务也就测个环境能用罢了。
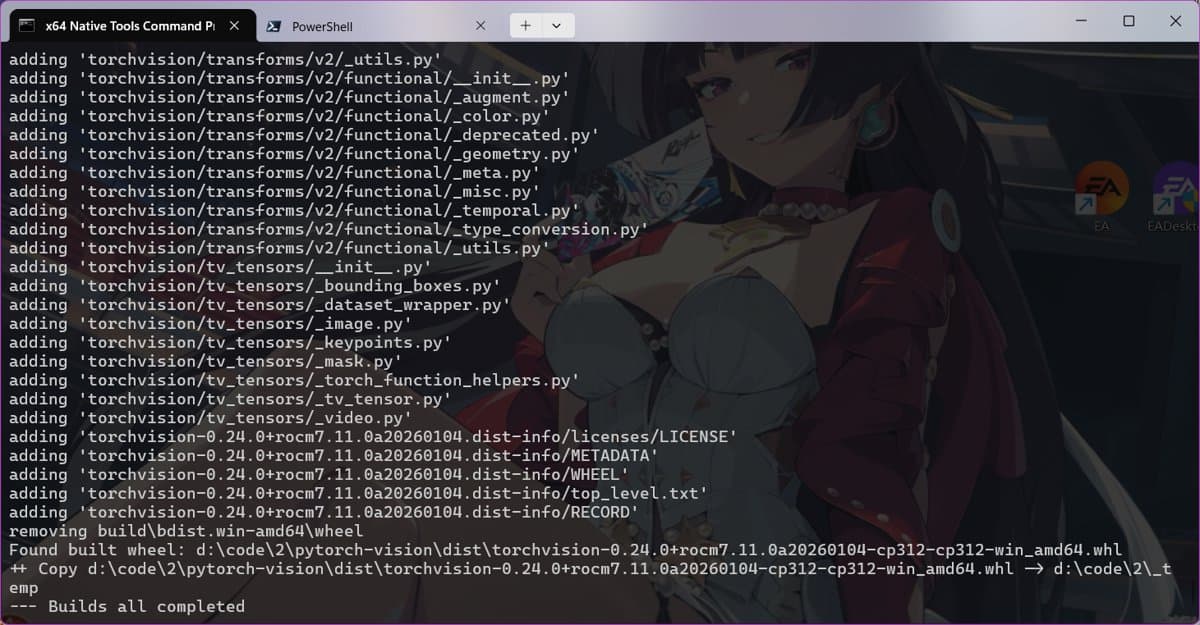
Windows+AMD+ROCm+PyTorch这地狱级组合居然跑通了。无非是用了官方ROCm和保守的PyTorch 2.9.1,避开新版本那些破事。下一步?总算能试试炼丹和AI画图了。
呵,折腾半天才发现没法从site-packages直接提取Wheel,还得从官方源重新拖。几个G的ROCm全家桶,预编译好的二进制乐高,省得下次再对着源码干等几小时。
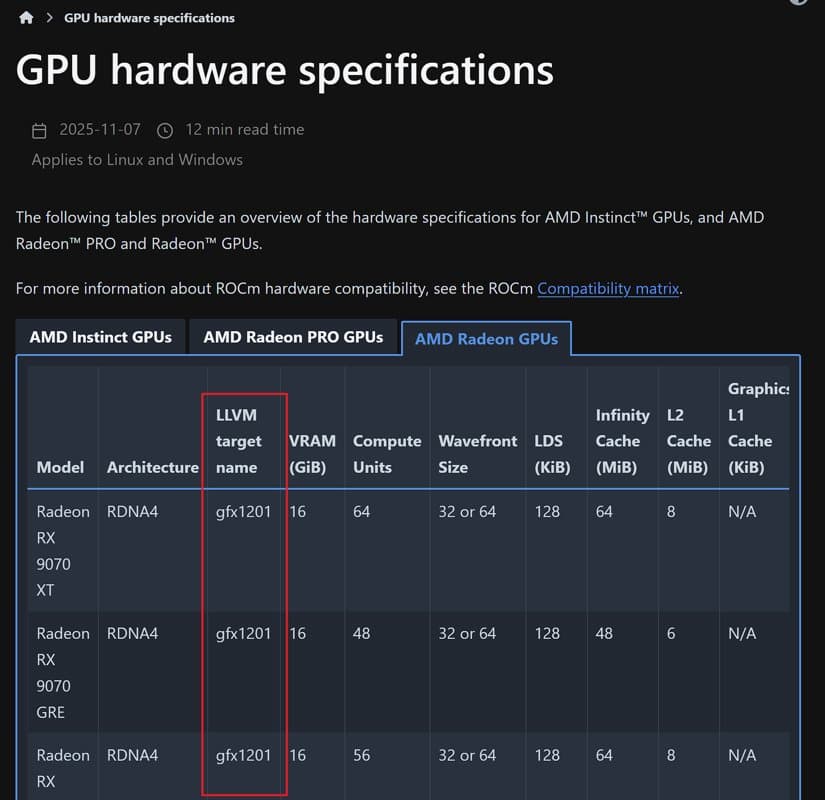
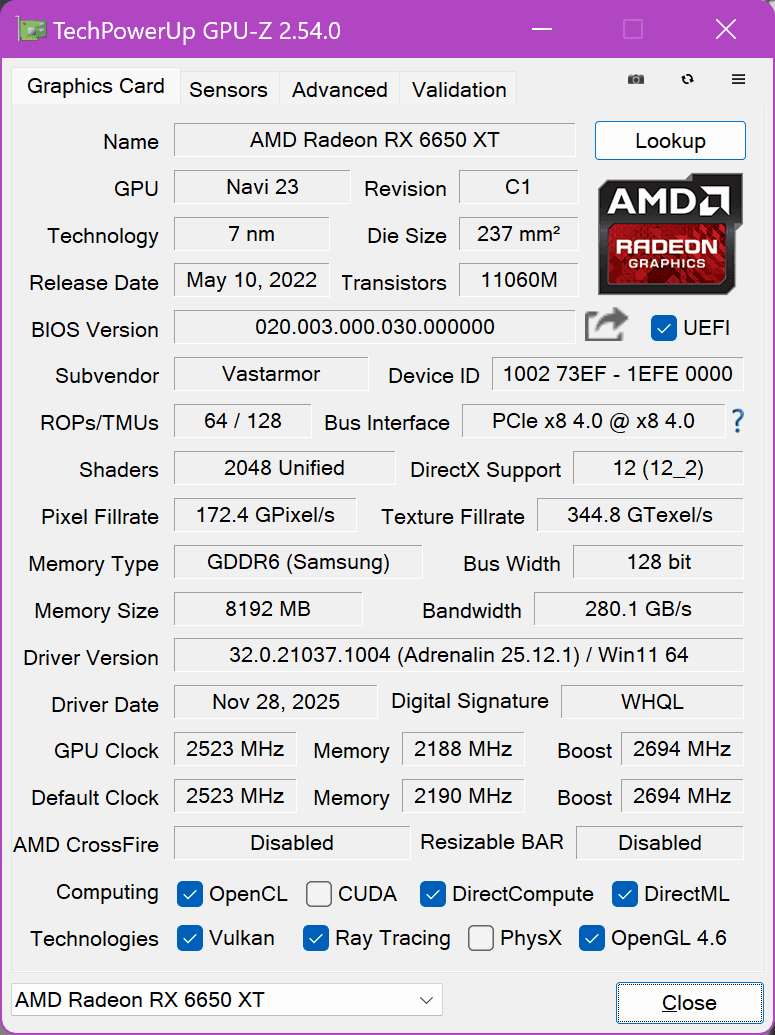
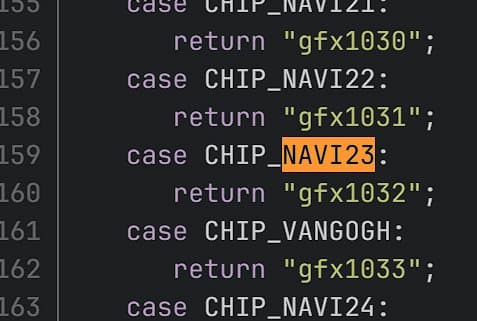
用6650XT在Windows上跑PyTorch?AMD官方都不支持这卡,还得自己编译ROCm。折腾一晚上环境变量和编译错误,结果连个wheel都没生成出来。所以为什么非要在Windows上给A卡炼丹?
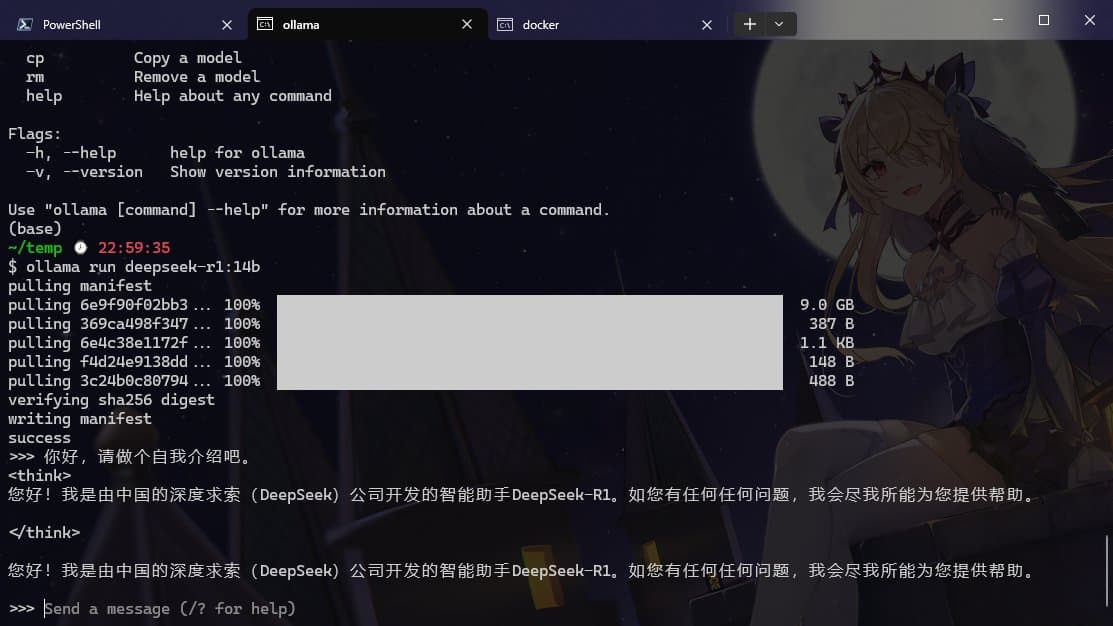
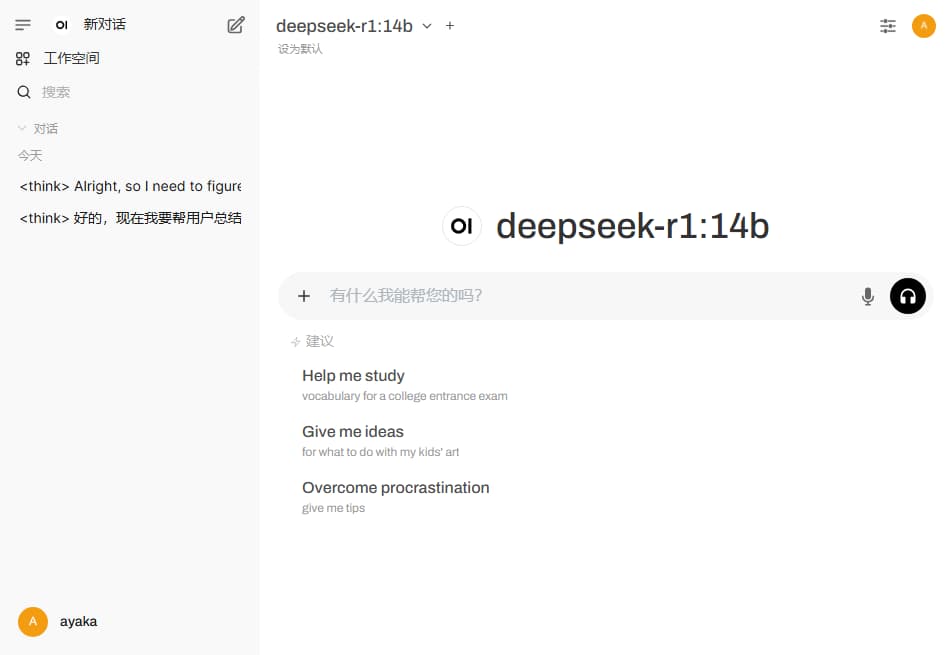
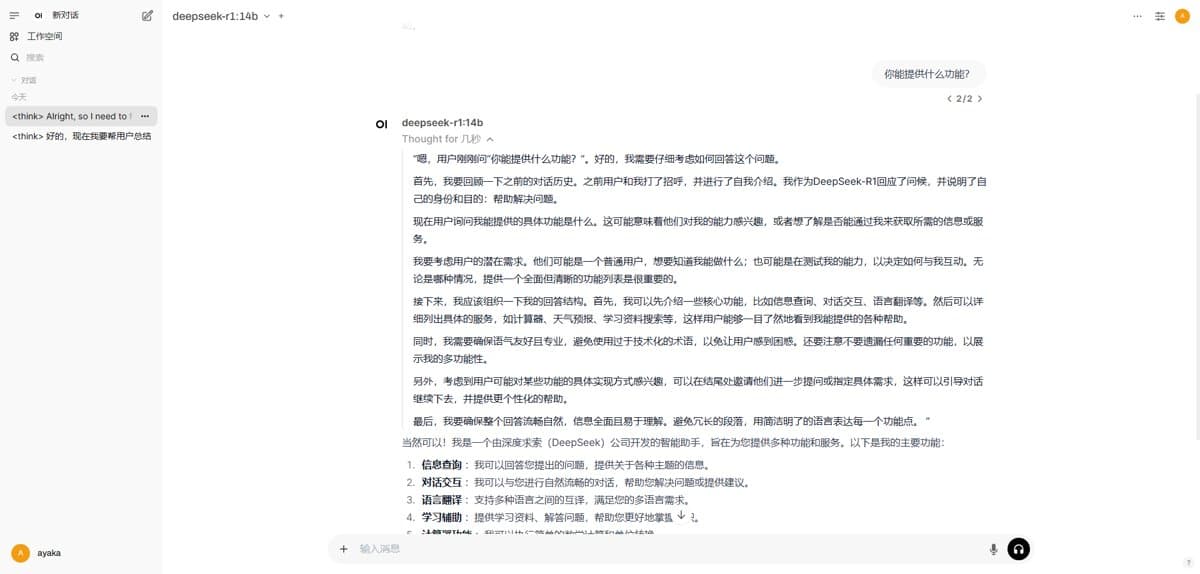
DeepSeek官网又崩?本地部署14b模型,web界面倒还凑合。国产大模型热度高,服务器不行就自己搭,呵。代码能力待验证,反正比官网强。
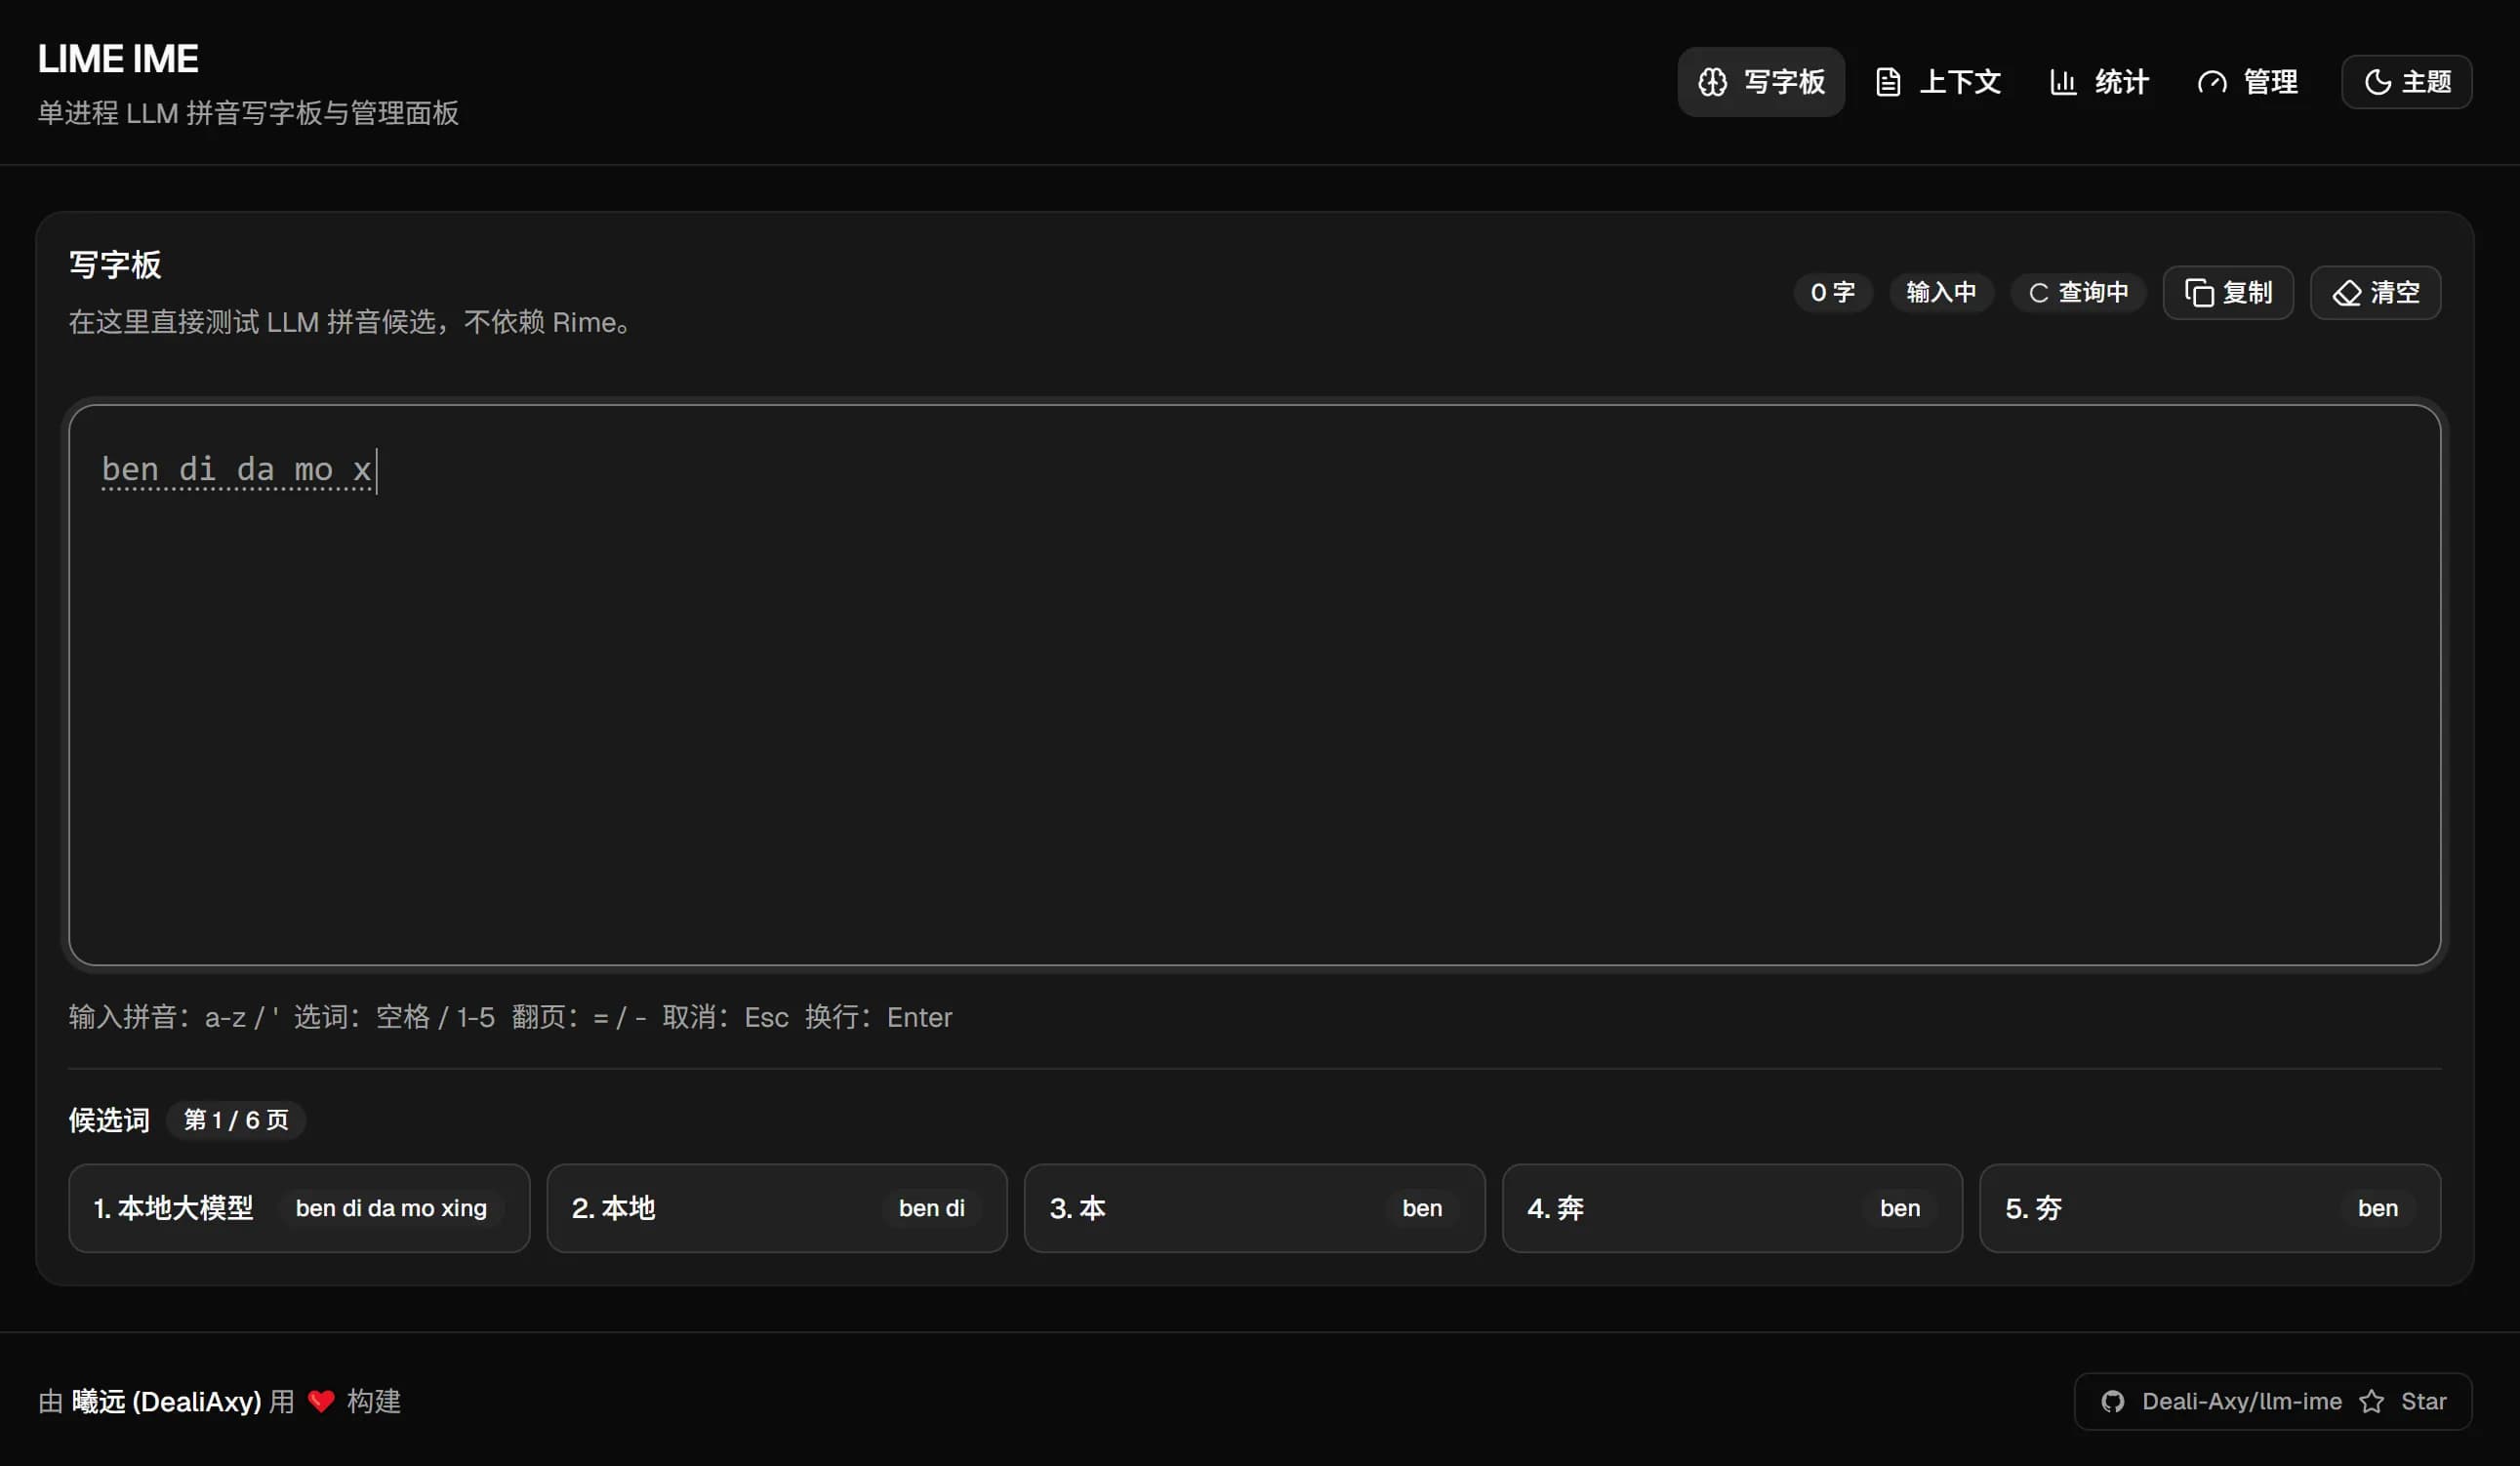
一个拿350MB小模型给输入法做语境排序的实验,思路倒是比那些堆参数的玩意儿清醒。不过老哥,先用着Web版就别急着吹原生输入法框架,等你能把打字延迟压到100ms以下再说。
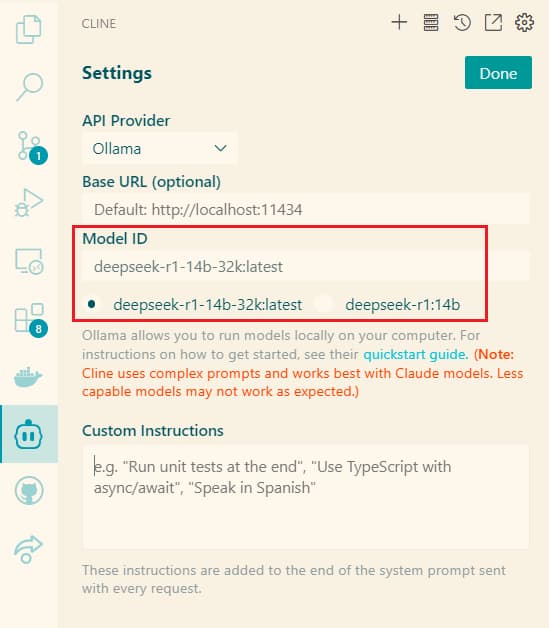
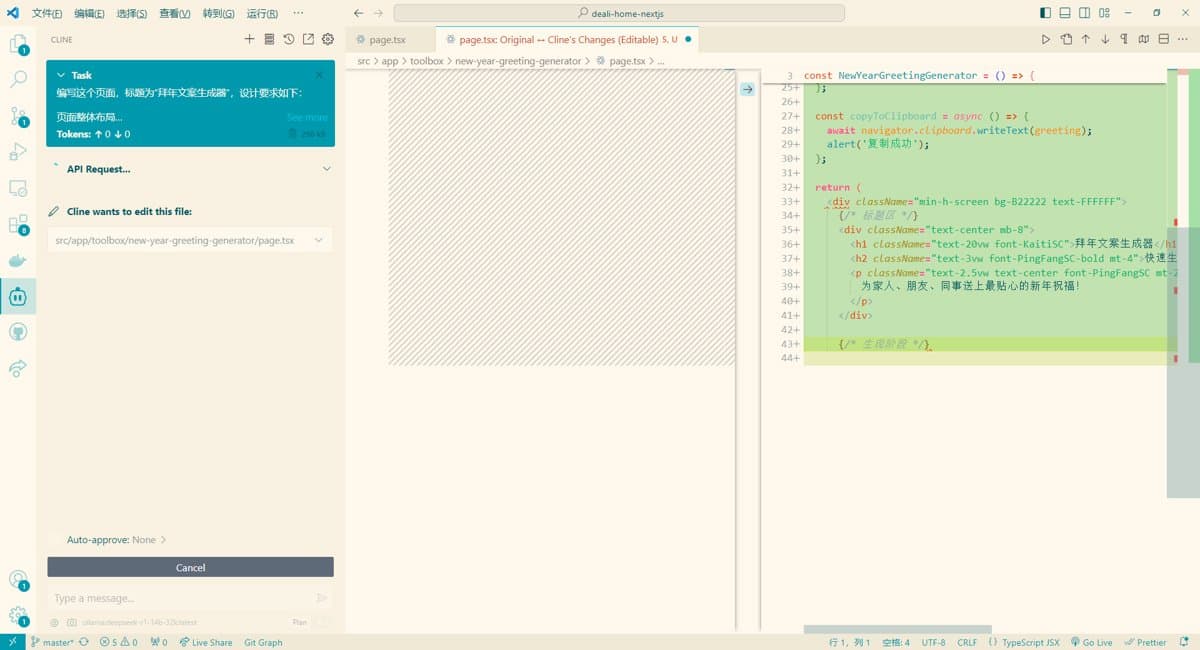
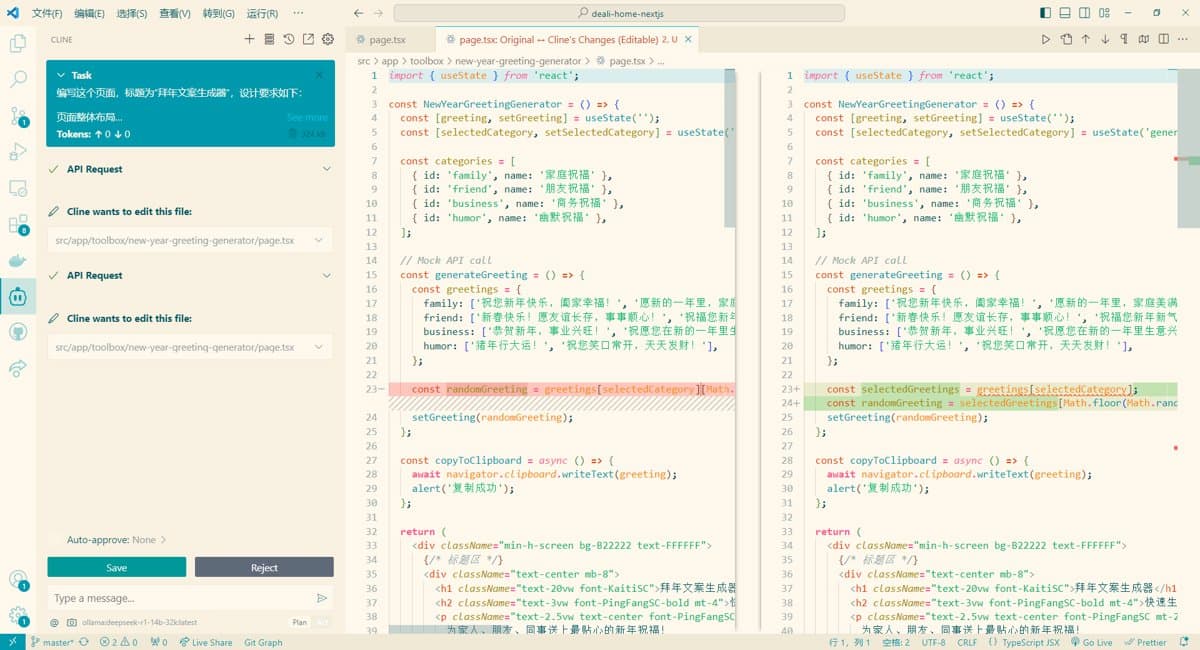
Cursor太贵?DeepSeek+Cline勉强能用,但token烧得比我还快。生成的代码bug一堆,还不如自己敲。32k上下文调整后总算不报错,效果嘛,也就那样。
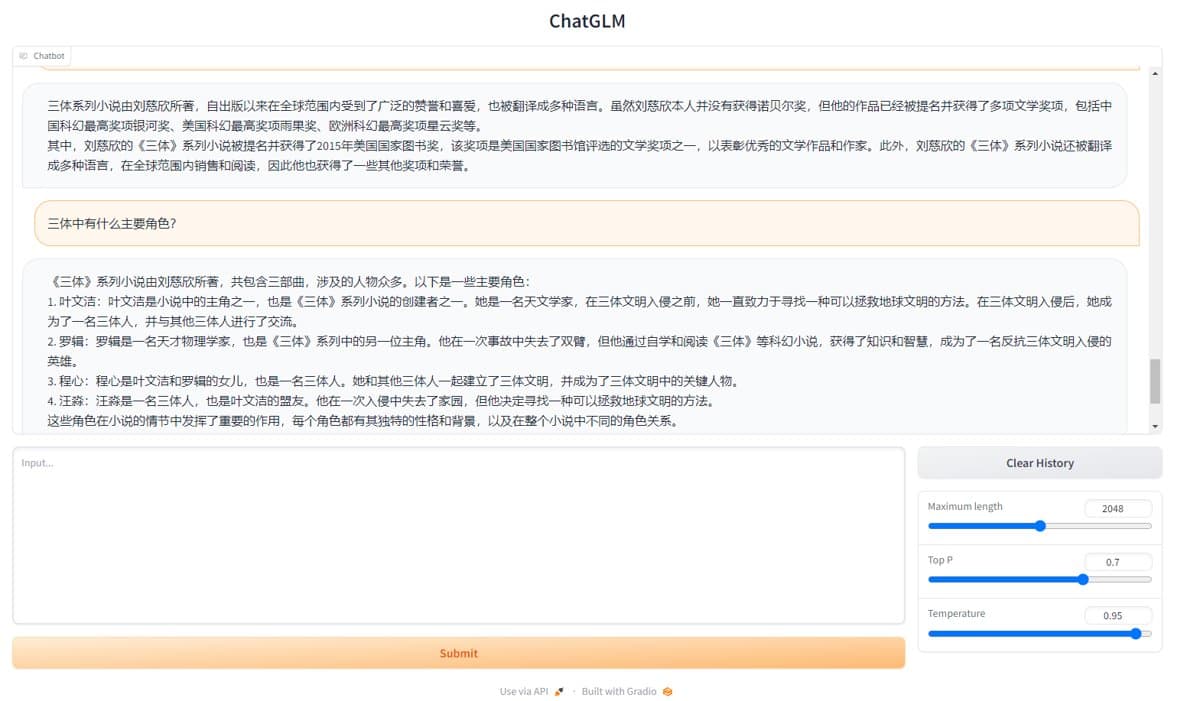
又来折腾LLM本地部署?ChatGLM-6B在6GB显存下就能跑,MOSS却要显存翻倍,这差距。硬件要求高得离谱,但作者硬是在Ubuntu上搞定,佩服?开源LLM本地部署指南,就这?