

ChatGLM-6B本地部署
下载项目代码 git clone https://github.com/THUDM/ChatGLM-6B.git 创建虚拟环境,建议使用 conda 管理 conda create -n chatglm python==3.8 安装依赖 conda activate chatglm pip install -r requirements.txt conda install cudatoolkit=
下载项目代码
git clone https://github.com/THUDM/ChatGLM-6B.git
创建虚拟环境,建议使用 conda 管理
conda create -n chatglm python==3.8
安装依赖
conda activate chatglm
pip install -r requirements.txt
conda install cudatoolkit=11.7 -c nvidia
PS:没有安装
cudatoolkit的话,会报RuntimeError: Library cudart is not initialized错误但 issues 里也有人说可以通过使用CPU输出量化模型后直接调用的方式解决,暂未尝试。
硬件需求
| 量化等级 | 最低 GPU 显存(推理) | 最低 GPU 显存(高效参数微调) |
|---|---|---|
| FP16(无量化) | 13 GB | 14 GB |
| INT8 | 8 GB | 9 GB |
| INT4 | 6 GB | 7 GB |
修改一下启动参数
model = AutoModel.from_pretrained("THUDM/chatglm-6b", trust_remote_code=True).half().cuda()
使用量化模型
# 按需修改,目前只支持 4/8 bit 量化
model = AutoModel.from_pretrained("THUDM/chatglm-6b", trust_remote_code=True).quantize(4).half().cuda()
下载模型和启动 Gradio 界面
cd ChatGLM-6B
python web_demo.py
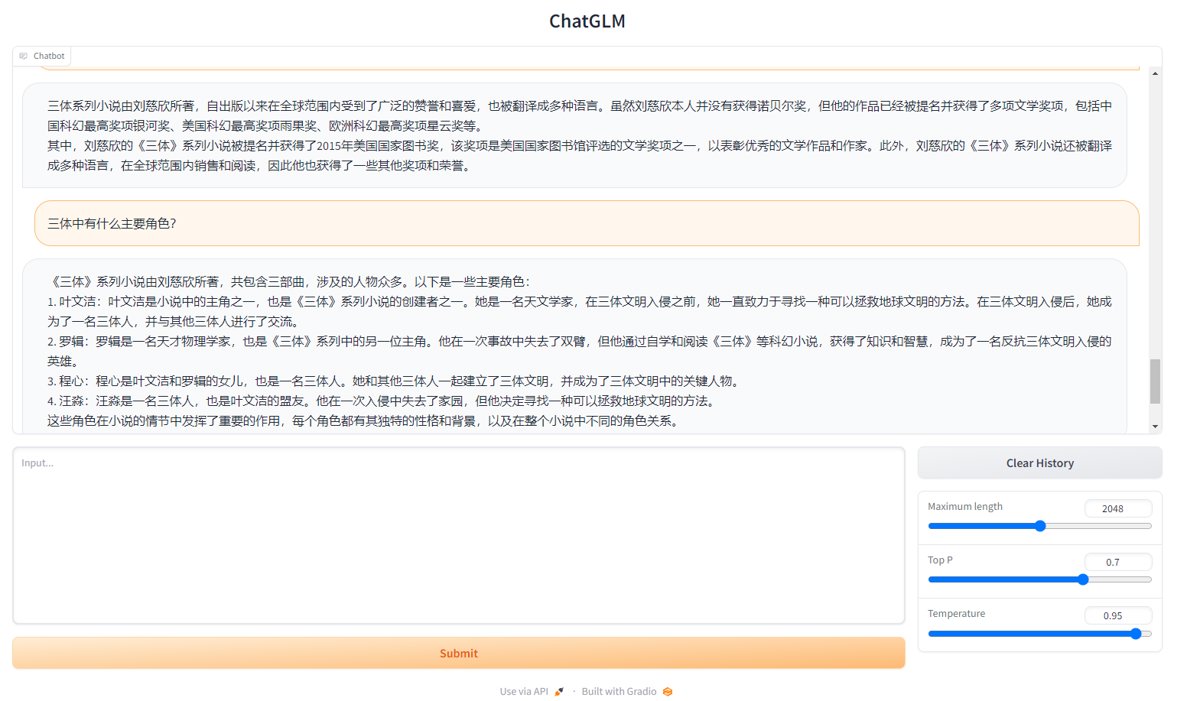
运行效果
_EOF_
ChatGLM-6B本地部署
- 本文作者:
- 程序设计实验室
- 版权声明:
- 本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!
相关文章
LLM探索:为ChatGLM2的gRPC后端增加连续对话功能
给ChatGLM2的gRPC后端硬塞了连续对话功能,改了proto、C#客户端和Python服务端代码。OpenAI格式转ChatGLM格式?真够折腾的,幸好有loguru。搞定了,但调试gRPC还是麻烦,考虑改OpenAI接口了。
2026-05-09 · LLM · 约 1 分钟
LLM探索:GPT类模型的几个常用参数 Top-k, Top-p, Temperature
A recent breakthrough in artificial intelligence (AI) is the introduction of language processing technologies that enable us to build more intelligent systems with a richer understanding of language than ever before. Large pre-trained Transformer language models, or simply large language models, vastly extend the capabilities of what systems are able to do with text.
2026-05-09 · LLM · 约 1 分钟
2GB 显存还能跑大模型吗?我在 MX250 老笔记本上部署 Qwen3.5 2BB
七年前的Matebook14,MX250显存2GB,硬塞Qwen3.5 2B——这届玩家是真的敢。核心思路倒是比模型选择更值得学:先看清楚硬件预算,再决定能跑什么,而不是硬上7B然后等CPU掉帧到怀疑人生。1.81GiB直接顶满2GB显存,KV Cache挤出来的空间里,4K Context刚好够用。至于Agent场景?省省吧,2B让MX250当推理节点做轻量任务已经仁至义尽。
2026-09-15 · LLM · 约 1 分钟
用本地大模型驱动中文输入法,我做了一个实验性的项目
一个拿350MB小模型给输入法做语境排序的实验,思路倒是比那些堆参数的玩意儿清醒。不过老哥,先用着Web版就别急着吹原生输入法框架,等你能把打字延迟压到100ms以下再说。
2026-05-09 · LLM · 约 1 分钟
讨论
共 0 条加载评论中…