多个约束条件下的二维装箱问题——寻找《开罗拉面店》最优布局之代码解析(五)遗传算法解析
前言 遗传算法的一些思路我在开篇有提到一些,这里给出具体过程: 1、生成两个种群,分别使用BL算法和BL_plus算法; 2、开始迭代 3、调用两个种群的update_max()函数更新最优个体 4、如果两个种群中有最优解(也就是12家店铺全部铺上去了),则跳出循环,返回该个体; 5、如果达到迭代次数,则跳出循环,返回两个种群的最优个体; 6、如果达到交换迭代次数,则: 假设种群P1的最优个体适应
目录3 个章节
前言
遗传算法的一些思路我在开篇有提到一些,这里给出具体过程: 1、生成两个种群,分别使用BL算法和BL_plus算法; 2、开始迭代 3、调用两个种群的update_max()函数更新最优个体 4、如果两个种群中有最优解(也就是12家店铺全部铺上去了),则跳出循环,返回该个体; 5、如果达到迭代次数,则跳出循环,返回两个种群的最优个体; 6、如果达到交换迭代次数,则: 假设种群P1的最优个体适应值为fbest1,P2的最优个体适应值为fbest2 (1)若fbest1>fbest2,则用P1的最优个体替换P2的最劣个体; (2)若fbest1<fbest2,则用P2的最优个体替换P1的最劣个体; 7、对两个种群分别进行选择、交叉、变异
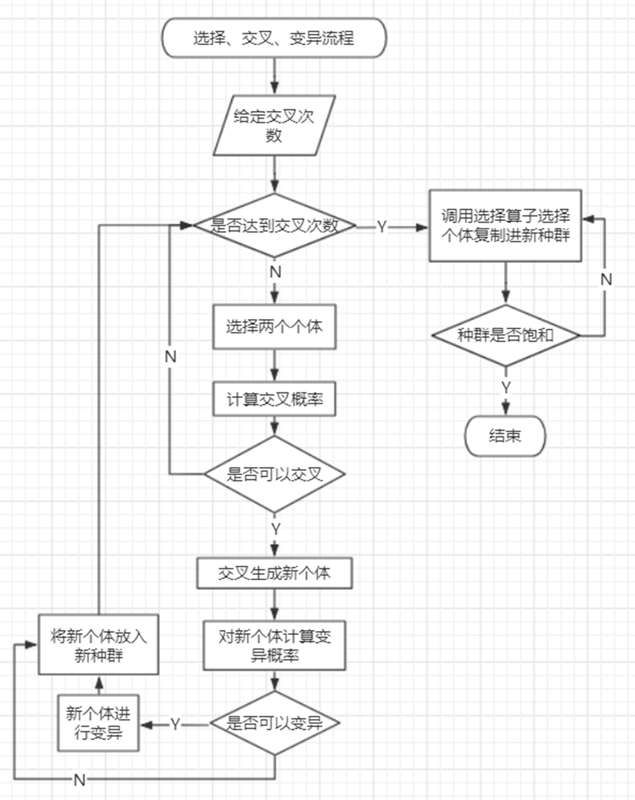
8、更新两个新种群的最优个体 9、若新种群最优个体的适应值小于旧种群最优个体适应值,则用旧种群的最优个体替换新种群的最劣个体。
核心代码
/// <summary>
/// 遗传算法
/// </summary>
/// <param name="path">店铺数据位置</param>
/// <param name="w">地区宽度</param>
/// <param name="h">地区高度</param>
/// <param name="iterations">迭代次数</param>
/// <param name="size">种群大小</param>
/// <param name="change">交换迭代次数</param>
/// <param name="crossover_frequency">交叉频率</param>
/// <param name="Pc1">用于计算交叉概率的参数一</param>
/// <param name="Pc2">用于计算交叉概率的参数二</param>
/// <param name="Pm1">用于计算变异概率的参数一</param>
/// <param name="Pm2">用于计算变异概率的参数二</param>
/// <param name="op_int">在基因片段一上的交叉算子</param>
/// <param name="op_bool">在基因片段二上的交叉算子</param>
/// <param name="va_int">在基因片段一上的变异算子</param>
/// <param name="va_bool">在基因片段二上的变异算子</param>
/// <returns>最优个体</returns>
public static Individual Inheritance(string path, int w, int h, int iterations, int size, int change,
    double crossover_frequency, double Pc1, double Pc2, double Pm1, double Pm2, operator_int op_int,
    operator_bool op_bool, variation_int va_int, variation_bool va_bool)
{
    Population pop1 = new Population(path, w, h, size, "BL");
    Population pop2 = new Population(path, w, h, size, "BL_plus");
    int fbest;
    for (int iteration = 0; iteration < iterations; iteration++)
    {
        pop1.update_max();
        pop2.update_max();
        fbest = pop1.fmax > pop2.fmax ? pop1.fmax : pop2.fmax;
        Console.WriteLine("第{0}次迭代,最优解的适应度为:{1}", iteration, fbest);
        if (pop1.Fmax.character.Count == 12)
        {
            return pop1.Fmax;
        }

        if (pop2.Fmax.character.Count == 12)
        {
            return pop2.Fmax;
        }

        if ((iteration + 1) % change == 0)
        {
            int min_index_1 = pop1.find_min_index();
            int min_index_2 = pop2.find_min_index();
            if (pop1.fmax > pop2.fmax)
            {
                pop2.ind[min_index_2] = pop1.Fmax;
                pop2.update_max();
            }
            else if (pop1.fmax < pop2.fmax)
            {
                pop1.ind[min_index_1] = pop2.Fmax;
                pop1.update_max();
            }
        }

        int crossover_times = (int) (size * crossover_frequency);
        double cros_prob, r, var_prob;
        Individual parent1, parent2;
        List<Individual> new_ind = new List<Individual>();
        List<int[]> gene_int;
        List<bool[]> gene_bool;

        //处理pop1
        for (int i = 0; i < crossover_times; i++)
        {
            parent1 = pop1.ind[pop1.roulette()];
            parent2 = pop1.ind[pop1.roulette()];
            cros_prob = pop1.cros_probability(parent1, parent2, Pc1, Pc2);
            r = Population.rand_double();
            if (r <= cros_prob)
            {
                gene_int = op_int(parent1.gene_order, parent2.gene_order);
                gene_bool = op_bool(parent1.gene_rotate, parent2.gene_rotate);
                Individual child;
                int[] ge_int;
                bool[] ge_bool;
                for (int j = 0; j < 2; j++)
                {
                    child = new Individual(w, h, gene_int[j], gene_bool[j], "BL",
                        pop1.decode(gene_int[j], gene_bool[j]));
                    var_prob = pop1.mut_probability(child, Pm1, Pm2);
                    r = Population.rand_double();
                    if (r < var_prob)
                    {
                        ge_int = va_int(gene_int[j]);
                        ge_bool = va_bool(gene_bool[j]);
                        child = new Individual(w, h, ge_int, ge_bool, "BL",
                            pop1.decode(ge_int, ge_bool));
                    }

                    new_ind.Add(child);
                }
            }
        }

        while (new_ind.Count < size)
        {
            new_ind.Add(pop1.ind[pop1.roulette()]);
        }

        int index, fmax = 0;
        for (int i = 0; i < size; i++)
        {
            if (new_ind[i].fit_count() > fmax)
            {
                fmax = new_ind[i].fit_count();
            }
        }

        if (fmax < pop1.fmax)
        {
            index = 0;
            int fmin = int.MaxValue;
            for (int i = 0; i < size; i++)
            {
                if (new_ind[i].fit_count() < fmin)
                {
                    index = i;
                    fmin = new_ind[i].fit_count();
                }
            }

            new_ind[index] = pop1.Fmax;
        }

        pop1.ind = new_ind;

        //处理pop2
        new_ind = new List<Individual>();
        for (int i = 0; i < crossover_times; i++)
        {
            parent1 = pop2.ind[pop2.roulette()];
            parent2 = pop2.ind[pop2.roulette()];
            cros_prob = pop2.cros_probability(parent1, parent2, Pc1, Pc2);
            r = Population.rand_double();
            if (r <= cros_prob)
            {
                gene_int = op_int(parent1.gene_order, parent2.gene_order);
                gene_bool = op_bool(parent1.gene_rotate, parent2.gene_rotate);
                Individual child;
                int[] ge_int;
                bool[] ge_bool;
                for (int j = 0; j < 2; j++)
                {
                    child = new Individual(w, h, gene_int[j], gene_bool[j], "BL_plus",
                        pop2.decode(gene_int[j], gene_bool[j]));
                    var_prob = pop2.mut_probability(child, Pm1, Pm2);
                    r = Population.rand_double();
                    if (r > var_prob)
                    {
                        ge_int = va_int(gene_int[j]);
                        ge_bool = va_bool(gene_bool[j]);
                        child = new Individual(w, h, ge_int, ge_bool, "BL_plus",
                            pop2.decode(ge_int, ge_bool));
                    }

                    new_ind.Add(child);
                }
            }
        }

        while (new_ind.Count < size)
        {
            new_ind.Add(pop2.ind[pop2.roulette()]);
        }

        fmax = 0;
        for (int i = 0; i < size; i++)
        {
            if (new_ind[i].fit_count() > fmax)
            {
                fmax = new_ind[i].fit_count();
            }
        }

        if (fmax < pop2.fmax)
        {
            index = 0;
            int fmin = int.MaxValue;
            for (int i = 0; i < size; i++)
            {
                if (new_ind[i].fit_count() < fmin)
                {
                    index = i;
                    fmin = new_ind[i].fit_count();
                }
            }

            new_ind[index] = pop2.Fmax;
        }

        pop2.ind = new_ind;
    }

    if (pop1.fmax > pop2.fmax)
    {
        return pop1.Fmax;
    }

    return pop2.Fmax;
}
最后
以上便是我寻找《开罗拉面店》最优解的全部过程啦!中间我走了很多弯路,甚至还准备了十几个参数准备拿来调参的,没想到才迭代了130多次就出结果了,非常幸运!不过其实也很好理解,因为按照我改进的算法生成的初始解,本来就离最优解不远,收敛速度快是很显然的。
最后贴上我找到的两个最优解:
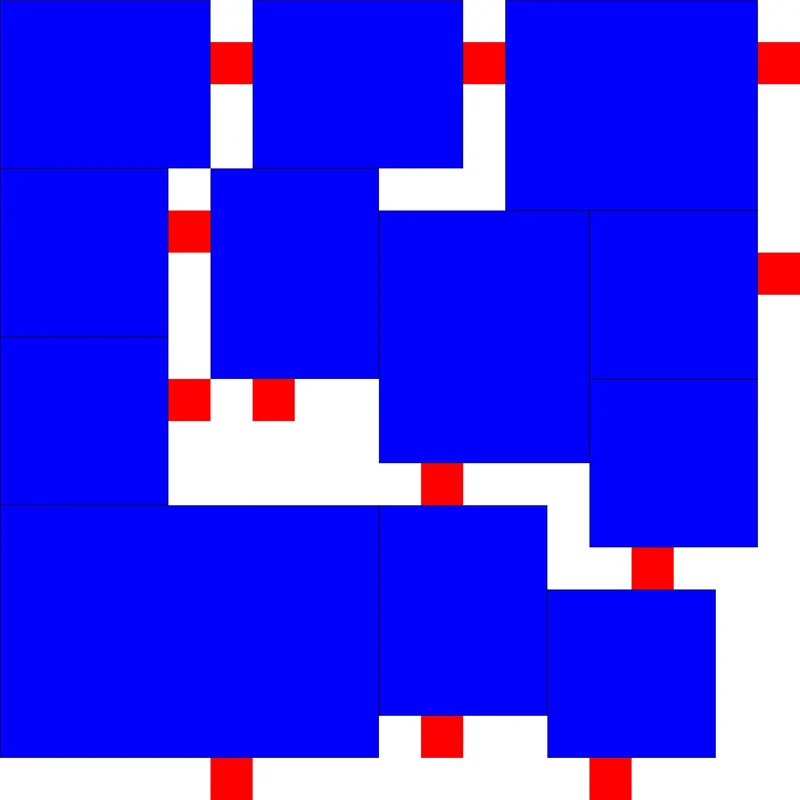
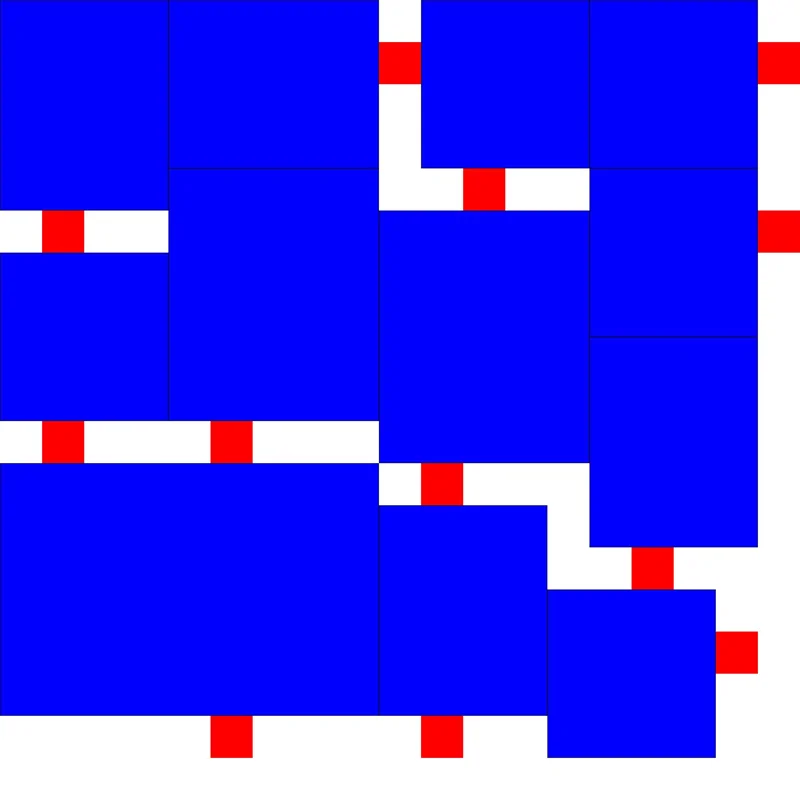
_EOF_
多个约束条件下的二维装箱问题——寻找《开罗拉面店》最优布局之代码解析(五)遗传算法解析
- 本文作者:
- 程序设计实验室
- 版权声明:
- 本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!
相关文章
使用分形思想,通过图灵完备的机器赛跑关卡,并获得小机快跑成就
本文将用尽量通俗易懂的语言, 为了解过和没了解过图灵完备和分形的读者讲解用分形思想来通过机器赛跑这一关并达成成就“小机快跑”的思路, 同时也将给出实现该思路的汇编代码。
2024-02-06 · 算法/机器学习 · 约 1 分钟
多个约束条件下的二维装箱问题——寻找《开罗拉面店》最优布局之代码解析(三)
种群类:Population 属性 种群类首先要储存的便是上一篇中提到的原始基因;其次为了应用精英保存策略、择伏分配等,需要记录最优个体的相关信息;同时在计算交叉变异概率的时候,需要用到求平均适应值的方法,所以为了简化计算,储存每个个体的适应值是很有必要的。 /// summary /// 个体列表 /// /summary public ListIndividual ind; /// summ
2021-12-18 · 算法/机器学习 · 约 1 分钟
多个约束条件下的二维装箱问题——寻找《开罗拉面店》最优布局之代码解析(二)
个体类:Individual 属性 一个个体在遗传算法中最关键的属性是基因编码和性状,为此还需要引出一个原始基因的定义(在敲代码的时候我把这玩意儿叫做基因库,但是后来查资料才发现,基因库是用来储存优秀个体,提高种群质量的,和我这里的作用并不相同,所以作出修正)。原始基因就是题目给定的这12个店铺,而在生成个体的基因的时候就只是单纯的在这条原始基因上进行随机重排序操作和随机旋转操作;性状则是进行这两
2021-12-18 · 算法/机器学习 · 约 1 分钟
推荐系统开发实践:Surprise库基本用法
首先是构建数据集 这里我使用了随机生成用户和项目,以及用户对项目的评价,喜欢(1)与不喜欢(0) import random import pandas import numpy as np def build_dataframe() - pandas.DataFrame: datasets = { 'userID': [], 'itemID': [],
2021-12-18 · 算法/机器学习 · 约 1 分钟
讨论
共 0 条加载评论中…